ai 影片怎麼做擁抱與親吻:效果原理與一次就做對的方法
ai 影片裡最多人指定要做的兩個動作,就是擁抱與親吻。這兩款特效的難點不在動作幅度,而在兩張臉必須在同一塊像素上共存:來源照片的角度、光線與裁切一旦對齊,成品就會乾淨。
本頁內容
# ai 影片怎麼做擁抱與親吻:效果原理與一次就做對的方法
ai 影片最常被指定做的兩個動作,就是擁抱與親吻。表面上看,這兩個效果比跳舞簡單得多:沒有大幅度位移、沒有快速運鏡,只是兩個人靠近、接觸、停住。
但難的地方不一樣。跳舞的難點是「位移很大」,擁抱的難點是「兩個身分必須貼在一起」。畫面裡只要有兩張臉同時存在於相鄰的像素上,模型就得決定哪個特徵屬於誰,而這個決定從第一格做到最後一格。
好消息是:這個難點幾乎完全由輸入決定,而不是由生成過程決定。照片對了,提示詞寫清楚了,成品就會穩。
「兩個人靠近」為什麼是 ai 影片 最難的一段
模型的工作並不是「把兩個人搬在一起」,而是逐格推測畫面。單人鏡頭裡,它只要維持一張臉;雙人接觸的鏡頭裡,它每一格都要維持兩張臉,而且這兩張臉會隨時間互相靠近、重疊、最後佔用同一塊區域。
重疊一旦發生,模型看到的是一塊混合的影像,它必須從這塊混合影像裡分離出兩個身分。分離得準,畫面就是一張自然的合照;分離得不準,五官就會開始互換。
這也是為什麼同樣的提示詞,換一組照片結果會差很多。模型不是不聽話,而是它拿到的幾何資訊不足。
兩種輸入方式,先選路線
| 項目 | 單張照片 | 兩張照片 |
|---|---|---|
| 身分一致性 | 較弱,重疊後容易互換特徵 | 較強,各自有獨立來源 |
| 場景一致性 | 較好,背景本來就是同一個 | 較弱,需要合成與補背景 |
| 前置作業 | 幾乎不用準備 | 要對齊角度、光線與比例 |
| 適合情況 | 已經有合照,想讓它動起來 | 沒有合照,或想指定特定人物 |
| 最常見的狀況 | 臉部融合、五官漂移 | 其中一人看起來像貼上去的 |
單張照片是最常見的路線,因為多數人手機裡本來就有合照。模型必須在同一個畫面裡為兩個身分各自發明動作,所以它對輸入品質最敏感:兩個人一重疊,照片裡就沒有任何資訊告訴它「哪張臉是誰」。
兩張照片是每個人各給一張。身分一致性好得多,因為每一張臉都來自自己的來源;但模型必須先把兩張合成同一個場景,再讓它動起來,而這一步會帶來光線不一致、比例不一致、背景必須被憑空補出來等問題。
還有一種是範本動作:工具內建一段預錄的擁抱或親吻片段,把你的主體對應上去。真實動作意味著真實的接觸幾何——肩膀怎麼疊、頭偏幾度、手放多高,都是拍攝時就存在的資訊,所以結果最連貫;代價是你只能用範本庫裡的角度與景別,照片也必須跟範本相容。
如果一個工具沒告訴你它屬於哪一種,那它幾乎肯定是第一種。
來源照片的三個檢核
這一節決定成品上限。與其研究提示詞,不如先把照片對齊。
檢核一,角度。 兩張臉都接近正面,拍攝高度相近。角度差太多,模型會把其中一張臉旋轉去配合另一張,身分就在旋轉的過程裡流失。
檢核二,光線。 兩張照片的色溫與亮度要接近。一邊是窗邊自然光、一邊是室內黃光,合成之後其中一個人會像被貼上去的。
檢核三,裁切。 上半身完整入鏡,肩膀與手都要在畫面內。肩膀被裁掉,模型就得自己發明手臂,位置通常不對。擁抱不需要全身入鏡,但肩膀與手一定要在框內;如果你手上是全身照,反而要先裁成上半身,讓模型把解析度集中在要用的區域。
| 輸入的狀況 | 畫面上會看到什麼 | 怎麼處理 |
|---|---|---|
| 兩張臉角度差很多 | 一張臉旋轉去配合另一張 | 兩張都選接近正面的照片 |
| 光線或白平衡不同 | 其中一人像被貼上去 | 先調成同一色調再生成 |
| 肩膀被裁掉 | 手臂位置不對、比例怪 | 上半身完整入鏡 |
| 背景太雜 | 身體重疊時背景扭曲閃爍 | 素色牆、天空或重度模糊 |
| 手靠近臉部 | 手指融合、多出指節 | 選手放低或手不在畫面內 |
| 解析度太低 | 臉部糊,沒有細節可以留住 | 短邊至少 1,000 像素 |
檢查的方法很簡單:把兩張照片並排,看眼睛的水平線是否大致對齊、下巴到頭頂的高度是否接近、受光方向是否相同。三項都接近就可以直接用;差很多就先裁切、調色,把頭部大小調到相近,再進行生成。
提示詞:寫幾何與結束狀態
| 目標 | 提示詞寫法 |
|---|---|
| 輕輕靠近 | 兩個人向彼此傾身並抱住,手臂環過肩膀,機位固定,兩人都完整入鏡 |
| 重逢 | 一個人從畫面左側走入並抱住另一個人,機位固定,整段都看得到兩個人 |
| 額頭相抵 | 兩個人把頭靠在一起直到額頭接觸,停住,機位固定,近景 |
| 親吻(點到為止) | 兩個人靠近並短暫接觸嘴唇,然後分開,機位固定,兩張臉都在畫面內 |
| 抱住不動 | 兩個人維持擁抱,只有細微的呼吸起伏,機位固定 |
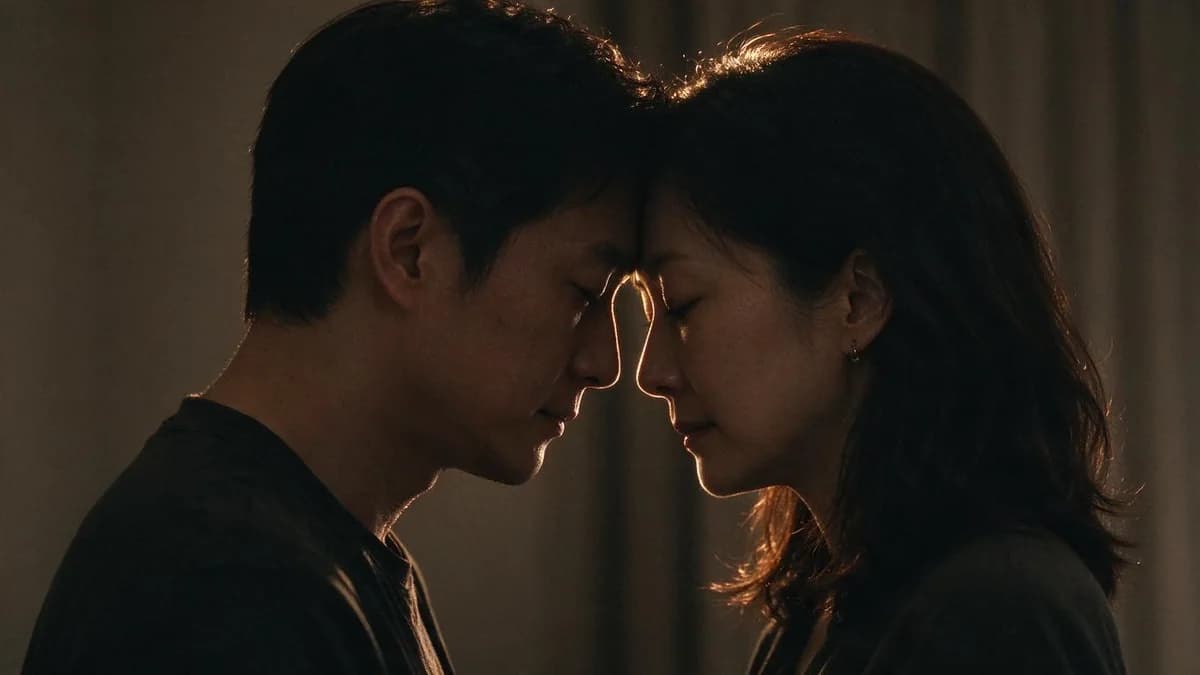
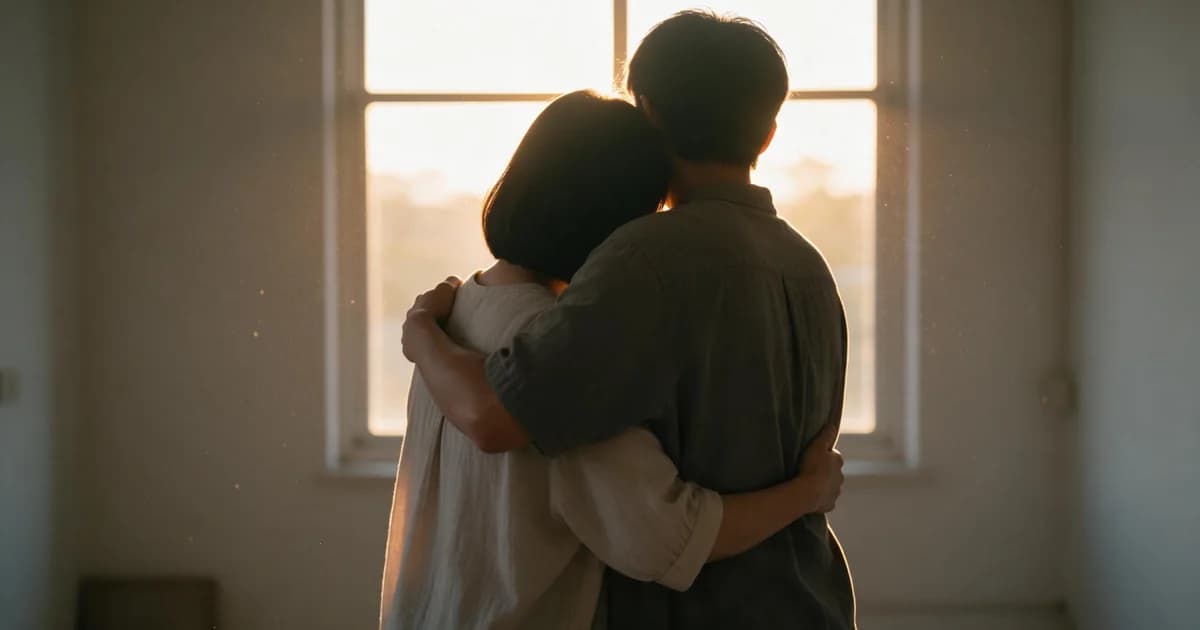
表格裡「額頭相抵」那一列的成品長這樣:兩顆頭靠在一起、視線往下、機位不動。把這個距離寫進提示詞,比寫「深情」有效。
三條規則做掉大部分的工作。
寫出結束狀態。 「直到額頭接觸」比「深情地」可靠得多。前者是一個可以被檢查的位置,後者是一個無法被驗證的感覺。
鎖住機位。 接觸過程中任何鏡頭運動,都會讓重疊區的誤差被放大。固定機位是這款特效最重要的一個設定。
寫清楚誰留在畫面內。 「兩人都完整入鏡」是一個模型真的會遵守的約束;不寫,它就會為了構圖把其中一個人推出框外。
還有一個常見的錯:堆疊形容詞。「浪漫、溫柔、電影感、感人」給了四個互不相關的約束,卻沒有給任何幾何資訊。把「深情」換成「手臂環過肩膀、頭靠在對方肩上」,畫面會立刻不一樣。
如果幾何寫了、機位鎖了、結束狀態也指定了,成品還是不對,下一步不是再改文字,而是換照片。文字能調整動作的方向,改不了兩張臉之間的距離與角度。
手與接觸點:最容易穿模的地方
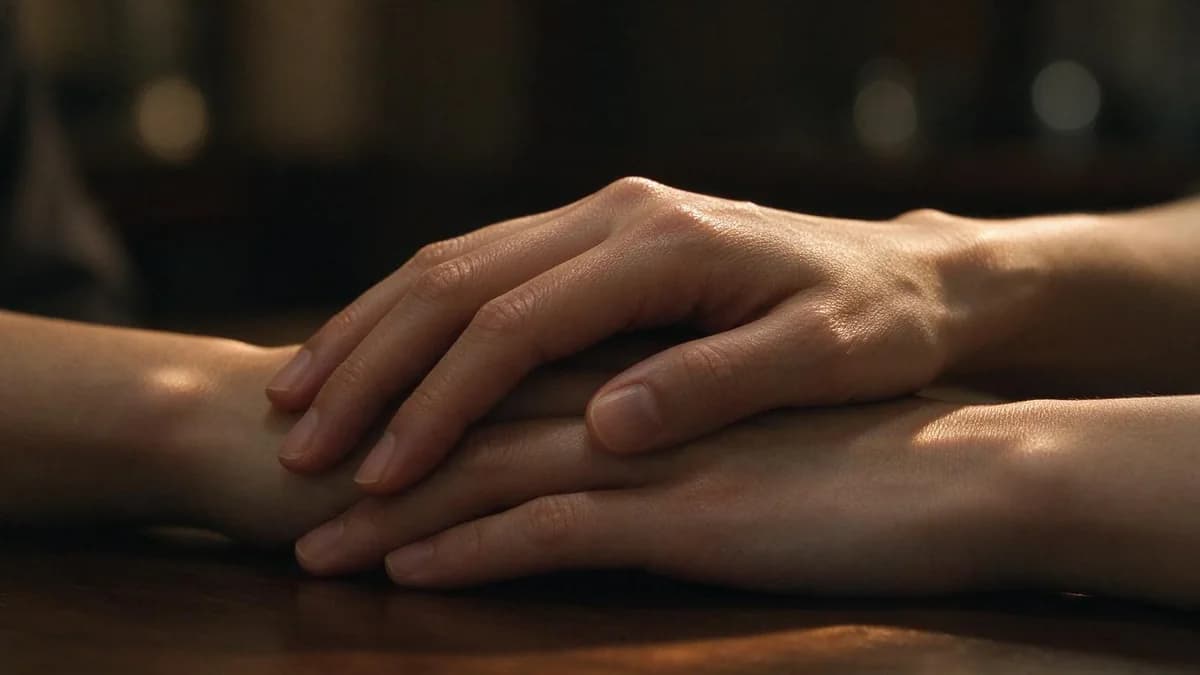
先看清楚這類鏡頭真正要生成的是什麼:手指怎麼疊、手掌怎麼貼、手腕停在哪個角度。這些極細的接觸關係才是畫面的說服力來源,也是模型最容易漏掉的地方。
手是這類鏡頭最容易出問題的部位,因為它同時滿足三個高風險條件:佔的像素少、需要極高的結構精度、而且經常靠近另一張臉。
先簡化手的位置。 手放在肩膀或背上,比放在臉頰上穩得多。手一旦遮住臉,模型就得同時處理「手」與「被遮住的半張臉」兩件事。
把手寫進描述。 「手輕放在對方背上」比什麼都不寫好。你不指定,模型就自己挑一個位置。
考慮讓手離開畫面。 取景收到胸口以上,手自然就不在框內。這不是迴避,而是把變數減到最少——近景靠表情與距離說服人,本來就不需要手。
同一個邏輯用在頭髮。 長髮蓋住肩膀、圍巾繞住脖子,都會在頭部移動時產生大量邊界推測,能避開就避開。
近景、中景、遠景:哪個最穩
擁抱與親吻的說服力來自距離,而距離由景別決定。三種景別各有它的穩定度。
近景,胸口以上。 最穩。畫面元素少,兩張臉佔掉大部分面積,模型不需要處理手、腰、腳。親吻與額頭相抵都用這個景別。
中景,腰部以上。 次穩。看得到手臂環抱的動作,是「抱住」最自然的景別,代價是要多注意手的位置,別讓它壓在對方臉上。
遠景,全身。 最不穩。框一大,要處理的元素成倍增加,腳與地面的接觸也會出問題。除非你要交代場景,否則沒有必要。
通則是:能用近景就用近景。你越想交代環境,就越要用穩定度去換。
三個固定設定:5 秒、直式 9:16、1080p
5 秒。 接觸發生的那幾格,是身分最容易被平均掉的時候;影格數越少,平均掉的時間越短。以每秒 24 格計算,5 秒是一百二十格,10 秒是兩百四十格。先把 5 秒做好,再考慮 10 秒。
直式 9:16。 Instagram Reels、YouTube Shorts、TikTok 都是直式,用 9:16 生成最省事。兩個人並肩、需要橫向空間時用 16:9;構圖很緊、幾乎只有兩張臉時才用 1:1。
1080p。 臉部一旦軟掉,觀看者會比任何瑕疵都更快判定「這是假的」。720p 在手機上還過得去,但只要畫面上要壓字或當封面,差距就很明顯。
順序是:先用 720p 跑 5 秒,確認接觸點合理,再用 1080p 跑同一組設定。高解析度比較慢,別把時間花在還沒驗證的動作上。
兩張臉糊在一起的處理順序
臉部融合的成因很具體:兩個身分必須在同一塊相鄰像素上共存好幾格,而模型沒有為每個主體分別建立條件。處理順序如下,效果由強到弱:
- 從「已經靠很近」的照片開始。 來源畫面裡兩張臉本來就快貼在一起,模型只需要移動幾毫米,難度幾乎消失。
- 改用有真實接觸幾何的範本。 一段錄好的擁抱,本身就把「兩個人怎麼貼合」編碼進去了。
- 把片段縮短。 五秒比十秒少掉一半需要維持重疊的影格。
- 最後才動提示詞。 提示詞能調整動作,但改不了照片裡四十度的角度差。
上架前的四個動作
- 看第一格與最後一格。 頭尾乾淨,代表可以剪、可以循環、可以停格。
- 用原生比例輸出。 直式素材就用 9:16 輸出,不要事後裁。匯出後在剪輯軟體裡對齊平台長度,別讓平台自動壓縮。
- 檢查手部。 逐格看手指數量與位置,那是觀看者最先注意到的地方。
- 留存來源照片。 同一組照片可以重複產出不同動作,重用比重新拍攝省事。
常見問題
只有一張照片也能做擁抱影片嗎? 可以,而且這是最常見的做法。兩張照片的身分一致性比較好;但如果單張照片裡兩個人本來就靠得很近,成品一樣可以很清晰。
為什麼兩張臉會糊在一起? 因為兩個身分必須在同一塊相鄰像素上共存好幾格,而模型沒有為主體分別建立條件。從更近的來源畫面開始,或改用有真實接觸動作的範本,就能改善。
該生成多長? 5 秒。10 秒會給身分更多影格去維持一致,先把 5 秒做好,再往上加。
為什麼手會穿過身體或長出多餘手指? 手在畫面裡佔的像素少,卻需要極高的結構精度;一旦靠近臉或彼此交疊,模型就分不清哪一塊屬於誰。把手放低、離開畫面,或改用範本,是最快的解法。
兩張照片的膚色不一樣怎麼辦? 先把兩張調到接近的色溫與亮度再生成。色差在合成階段會被當成「兩個不同場景」處理,越早對齊越好。
要用什麼比例? 社群用 9:16;兩個人並肩、需要橫向空間時用 16:9;構圖很緊、幾乎只有兩張臉時用 1:1。
延伸閱讀
如何把照片變成影片裡的來源照片原則,在這個效果上完全適用;AI 影片提示詞指南說明了怎麼寫出「撐得過一格以上」的動作描述。如果你是要把特定人物放進範本,而不是從零生成,用範本替換影片角色會更貼近需求。
想用自己的照片試試看,可以從範本頁挑一個效果開始。
本文這些條件,可以拿一張照片在圖片轉影片工具裡當場驗:先跑 5 秒一條,看主體和構圖撐不撐得住,再決定要不要往下做。