ai生成影片:用一張照片讓人物跳起舞的完整做法
ai生成影片最常被問的一題,就是能不能只靠一張照片讓人物跳起舞。可以,而且條件很具體:全身入鏡、鎖住機位、五秒長度、直式 9:16。這四個條件做對,動作就會穩,手腳也不會憑空長出來。
本頁內容
# ai生成影片:用一張照片讓人物跳起舞的完整做法
ai生成影片最常被問的一題,就是「只有一張照片,能不能讓人物跳起舞」。可以,而且做法比想像中更有紀律:真正決定成品的是四個固定條件——全身入鏡、鎖住機位、五秒長度、直式 9:16。這四項到位,動作就會穩;四項缺一,後面再怎麼修都很吃力。
舞蹈之所以是這類工具的壓力測試,是因為它把「大幅度位移」集中在幾秒內完成。人物一動,畫面裡幾乎每個區域都要跟著重算,而模型每一次重算,都必須同時回答兩個問題:動作往哪裡走、這個人還是同一個嗎。
這篇會把可控的部分一項一項拆開,讓你知道哪些設定該先做、哪些可以之後再調。
為什麼「跳舞」是 ai生成影片 的壓力測試
多數人以為工具是「把照片裡的人搬去跳舞」,實際上更接近「根據這張照片,推測接下來每一格長什麼樣」。模型先讀懂人物比例、服裝、光影與背景,然後在時間軸上一格一格生成新畫面。
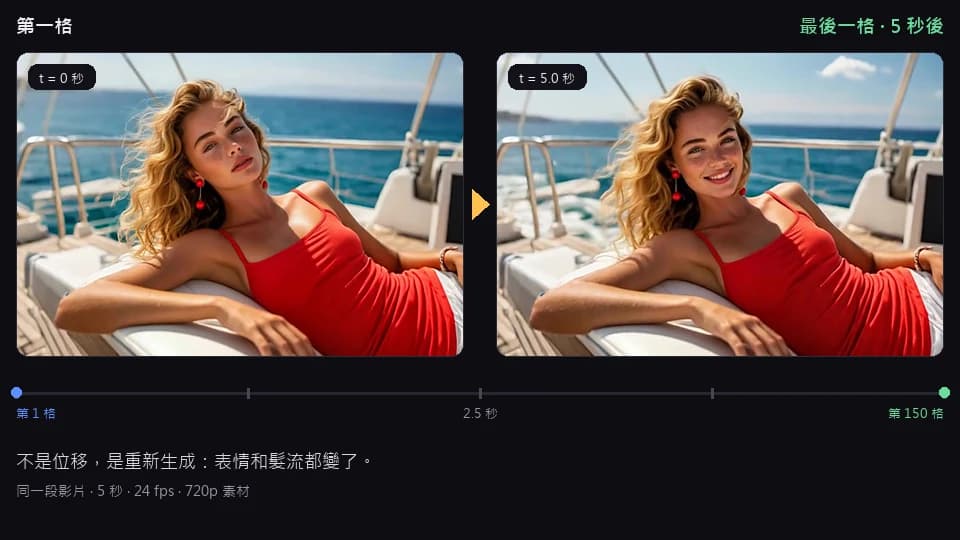
靜態人像只有一格要維持,舞蹈卻有上百格要維持,而且每一格的人物位置都不同。動作幅度越大,模型需要憑空補的資訊就越多:手抬起來,肩膀與衣服皺褶要跟著合理變化;頭轉過去,臉部特徵要重新推一次;腳跨出去,地面與陰影都要重畫。
理解了這件事,很多現象就變成工程問題,而不是靠猜的問題:只要減少模型需要自由發揮的範圍,畫面就會穩。這也是為什麼下面四個條件比任何形容詞都重要。
先確認你打開的是哪一種做法
同樣打著「舞蹈生成」的名義,市面上至少有三種不同機制,混在一起比較會得到錯誤的結論。
| 做法 | 動作來源 | 主體還原度 | 適用情況 |
|---|---|---|---|
| 單張照片生成 | 模型逐格推測 | 中,受來源照片影響大 | 只有照片、想指定特定人物 |
| 範本對應 | 真實拍攝的動作片段 | 高 | 想要連貫動作、能配合範本構圖 |
| 影片改風格 | 你自備的原始影片 | 最高 | 已有跳舞影片,只想換角色或畫風 |
單張照片生成最快、限制最少,也是多數人搜尋 ai生成影片 時心裡想的那一種。它對全身景或七分身景、背景乾淨的照片效果最好。
範本對應把一段真實拍攝的動作套到你的主體上,動作連貫性最好,因為底層不是推測出來的;代價是你只能用範本庫裡的角度與景別,而且照片構圖必須跟範本對得上。
影片改風格需要你自備素材,還原度最高,但如果手上只有照片,這條路就用不上。
動工前的四個固定條件
這四項是這篇最重要的部分,因為它們在按下生成之前就能確認,而且不需要任何技巧。
第一,全身入鏡。 腳一定要在畫面裡。腰部以上裁切的照片,不管提示詞寫得多詳細,都做不出踢腿、跳躍、跨步,因為模型沒有下半身的資訊可以參考。腳被裁掉,它甚至會把腿接在奇怪的位置。
第二,鎖住機位。 機位固定代表畫面框不會動。只要框會動,模型就必須同時處理「人物在動」與「鏡頭在動」兩套變化,而這兩套變化在畫面上混在一起,它很難判斷哪個位移該歸給誰。第一次生成一律要求固定機位,等動作乾淨了,再考慮加一點極緩慢的推鏡。
第三,5 秒。 五秒是甜蜜點,理由在後面的長度段落會細講。簡單說:要維持的影格越少,人物越容易保持同一個樣子。
第四,直式 9:16。 你的成品很可能要放上 Instagram Reels、YouTube Shorts 或 TikTok,這些都是直式。直接用 9:16 生成,模型從第一格就知道框有多窄,會把人物安排在框內;用 16:9 生成再裁,最先被切掉的往往是腳。
來源照片:比提示詞更值得花時間
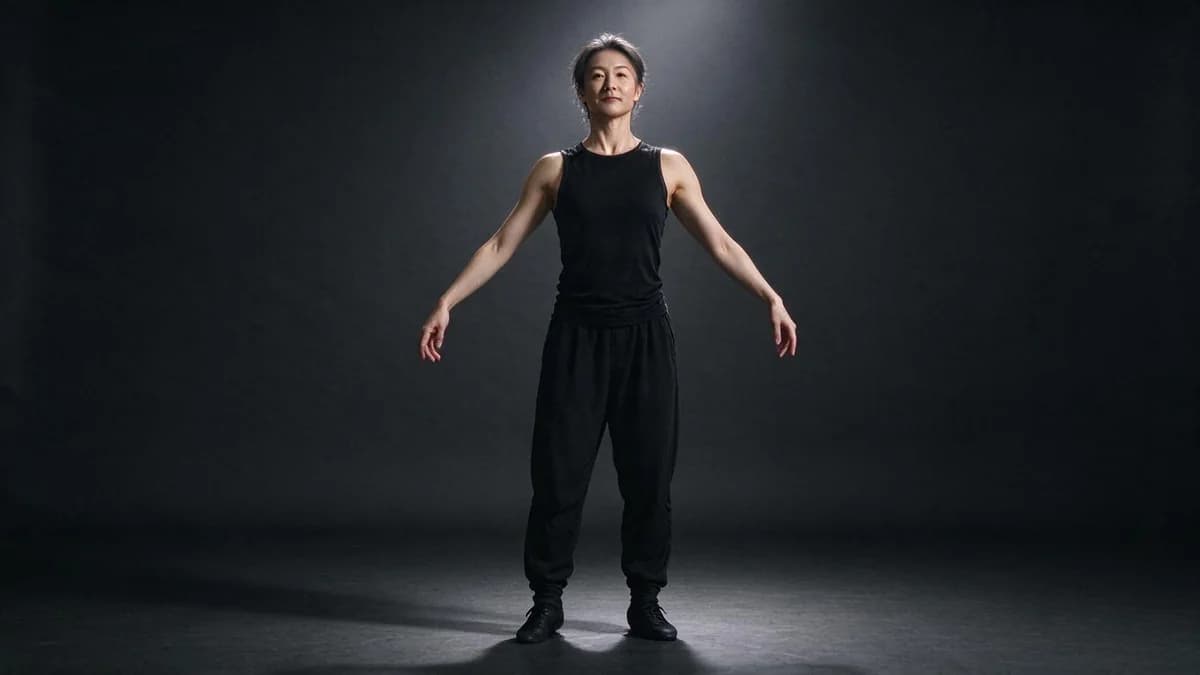
如果只能改一件事,先改照片。照片決定上限,提示詞只決定你有沒有碰到那個上限。
構圖。 全身入鏡,人物佔畫面高度的七成左右,四周留一點空間。留邊界這件事很重要:模型生成動作時會自動重新取景,你留得越寬,它越不會把腳切掉。
手臂與手。 手臂離開軀幹、雙手分開,是最穩的姿勢。手貼在身體上、兩手交握、手指互相重疊,都會讓前景與背景的邊界變模糊,模型分不清哪一塊屬於哪隻手。
背景。 素色牆、天空、大光圈散景都可以。背景裡的細節會跟著人物一起被推動、扭曲,越乾淨越穩。
光線。 均勻的柔光最好。臉上一半亮一半暗、強烈側光或逆光,都會讓模型在推測臉部時更容易偏掉。
解析度。 短邊至少 1,000 像素。太小的照片沒有細節可以留住,放大之後只會更軟。
手機拍攝的話,退後半步、把手機拿成直式,通常就能同時解決「腳不見」與「比例怪」兩個問題。
有三種照片先不要用:人物被切在膝蓋以上、手插口袋或抱胸、背景有明顯直線(窗框、門框、磁磚縫)。這些線條會跟著人物一起歪,換一張照片比在提示詞裡補救有效得多。
另外要注意影像品質:手機直拍的原檔通常夠用,但經過通訊軟體傳過一輪的照片會被壓縮,細節掉光,模型的推測就會更粗。要用就用原始檔。
提示詞:把動作拆成序列
動作類的提示詞,寫成一串「先做什麼、再做什麼」比寫成一個結果形容詞有效。具體的分解動作,永遠贏過抽象的形容。
| 想要的效果 | 提示詞寫法 | 為什麼這樣寫會穩 |
|---|---|---|
| 簡單搖擺 | 人物左右輕擺,肩膀放鬆,雙腳踩地不動,機位固定,全身入鏡 | 動作幅度小,沒有部位離開畫面 |
| 嘻哈踏步 | 人物做左右踏踏步,手臂自然垂在身側擺動,機位固定,全身入鏡 | 四肢與機位分開描述,模型不會自行加戲 |
| 轉身 | 人物轉一百八十度後停住,頭髮跟著轉動,機位固定,遠景 | 寫明結束狀態,避免無限旋轉 |
| 雙人同步 | 兩個人同步踏步,兩人都完整入鏡,機位固定,遠景 | 用構圖約束同時保住兩個主體 |
| 幼童跳舞 | 幼童在原地輕輕彈跳,雙手舉高,機位固定,全身入鏡 | 低振幅適合短秒數 |
底下有兩條通則。第一,永遠寫出機位。第二,永遠寫出景別——「全身入鏡」或「遠景」這幾個字,實際作用比任何風格形容詞都大。形容詞影響質感,景別影響構圖,而構圖才決定腳會不會被切掉。
第三條原則是隱形的:一次只寫一個主要動作。同時要求「轉身、跳躍、揮手、甩頭」,等於給模型四個互相競爭的目標,它會挑一個做得很誇張。真的需要多個動作,就寫成有先後順序的句子,例如「先向後退一步,再原地轉身」。
範本與提示詞,什麼時候該換跑道
兩種做法沒有優劣,只有適用時機。需要一段連貫、有節拍的舞步時,範本幾乎永遠比提示詞可靠,因為動作是真實拍攝的,模型只要對應,不需要發明。
需要指定角色、指定動作、或想要一個範本庫裡沒有的姿態時,提示詞驅動才是唯一的路。這時候你要接受一件事:動作的連貫性由你寫的序列決定,寫得越具體,成品越接近你要的。
判斷時機的方法很簡單:如果你已經把照片、機位、長度三項都收緊,動作還是不連貫,換範本會比繼續改文字有效。反過來說,如果你只是想要一個「有在動」的效果,提示詞版本通常更快。
拿到片段之後,最後一段工作發生在剪輯軟體裡:對齊節拍、裁掉多餘的頭尾、必要時把兩段接起來。模型負責生出動作,節奏由你在剪輯軟體裡決定,這樣的組合比要求模型自己踩點可靠得多。
5 秒與 10 秒:長度是線性放大的風險
以每秒 24 格計算,五秒大約一百二十格,十秒就是兩百四十格。每一格都要重新維持身分與解剖結構,所以時間越長,偏移累積的空間越大。
實務順序是這樣:先用五秒做出一段乾淨的版本,確認動作、構圖、手腳都對,再把同一組設定拉到十秒。反過來做——一開始就要求十秒——你會把時間花在一個還沒驗證的動作上。
想要更長的成品,還有兩個更穩的做法:把兩段五秒的片段接起來,或是用第一段的結尾影格當第二段的起點。剪接比一次生成十秒可控得多。
720p 與 1080p、9:16 與 16:9 怎麼選
| 用途 | 建議解析度 | 建議比例 |
|---|---|---|
| Instagram Reels、TikTok 直式短片 | 1080p | 9:16 |
| YouTube Shorts | 1080p | 9:16 |
| YouTube 橫式影片、官網嵌入 | 1080p | 16:9 |
| 快速測試動作與構圖 | 720p | 9:16 |
| 方形貼文、縮圖素材 | 1080p | 1:1 |
720p 在手機上還過得去,但一旦畫面上要壓字、放大、或拿來做封面,差距就很明顯。1080p 是多數平台的實用標準,也是這類影片的合理預設。
順序上,先用 720p 確認動作,再用 1080p 輸出要留下的那一版。高解析度生成比較慢,在動作還沒對之前就開最高規格,等於把時間花在錯的版本上。
手部與肢體:三個可執行的修法
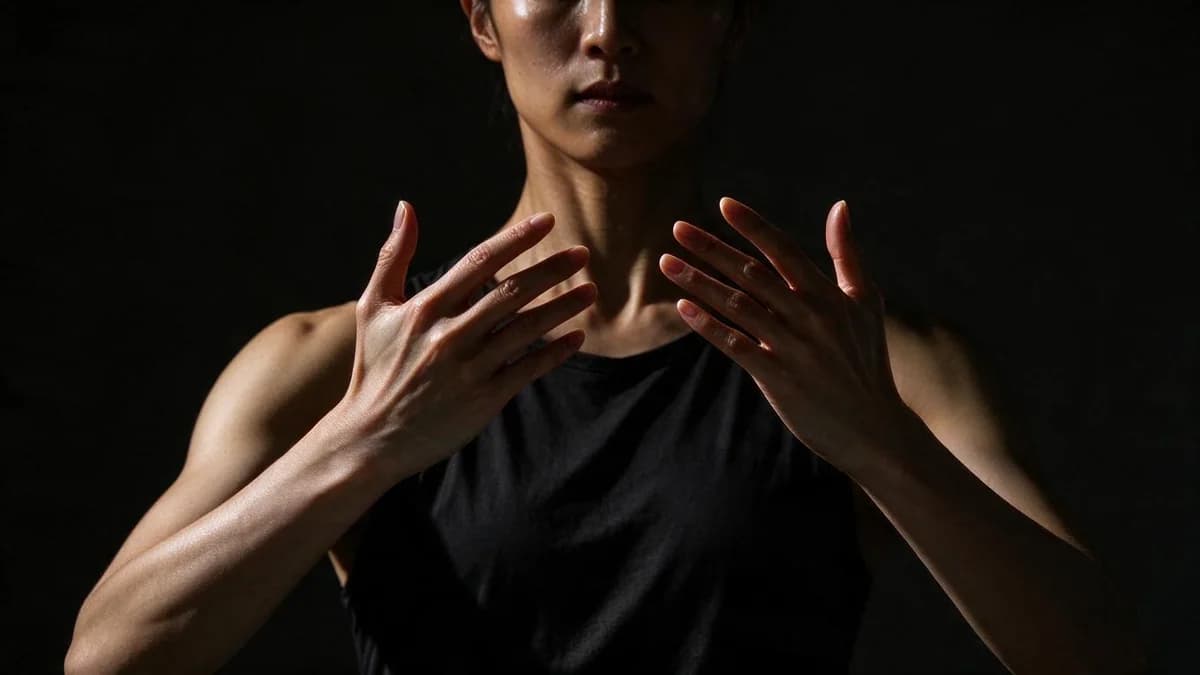
手容易出錯,是因為它在畫面裡佔的像素很少,卻需要極高的結構精度。五根手指、每根三個關節,模型每一格都要重新推一次;手一靠近軀幹、貼在臉上、或兩手交疊,前景與背景的邊界就模糊了。
修法一,選姿勢而不是事後修。 挑一張手臂與身體之間有空隙、雙手分開的照片。選照片時花三十秒,勝過生成後花半小時處理。
修法二,把手寫進動作描述。 例如「雙手自然垂在身側」、「手臂張開與肩同寬」。你不寫,模型就自己決定;你寫了,它就有一個明確的目標位置。
修法三,把複雜動作拆成獨立鏡頭。 需要手部細節的畫面(揮手、比動作),單獨生成一段短的,不要塞進整支舞的長片段裡。
同樣的邏輯適用於腳與頸部。腳掌著地、腳尖方向清楚的照片比較穩;長髮壓在肩上、圍巾繞住脖子這類造型,會在頭部轉動時產生大量邊界推測,能避開就避開。
從生成到上架:Reels、Shorts、TikTok 的流程
- 挑兩張可信的來源照片,都符合全身入鏡、背景乾淨、光線均勻。
- 用 720p、五秒、9:16 跑第一次,只確認動作與構圖。
- 動作對了,再用 1080p 跑同一組設定,輸出要留下的版本。
- 檢查第一格與最後一格。頭尾乾淨,代表這段影片可以剪、可以循環、可以在任何位置停格。
- 上架時把主體放在畫面中央偏上,因為平台的介面元素會蓋住下方與右側。
- 把有效的組合記下來:照片、提示詞、時長、比例。同一組設定是可重複的,下次直接複製比重新摸索快得多。
常見問題
只有一張照片真的能做跳舞影片嗎? 可以。關鍵在構圖:全身入鏡、腳在畫面內、背景簡單,這三個條件成立,動作就有足夠的資訊可以推。
該生成五秒還是十秒? 先五秒。五秒的版本確認動作正確之後,再拉長到十秒,會順得多。
為什麼跳到一半臉會變? 快速轉頭與側臉角度是身分最難維持的地方。讓頭部相對穩定、避開大幅回頭的動作、把長度壓在五秒,就能改善大部分情況。
一定要用範本嗎? 不一定。範本給你真實的動作,但把你限制在範本庫裡;提示詞驅動的照片轉影片更自由,但需要你把動作寫清楚。
TikTok 或 Reels 要用什麼比例? 9:16。用 16:9 生成再裁切會切掉腳,而腳通常正是舞蹈影片的重點。
可以先做 16:9 再裁成直式嗎? 不建議。裁切會切掉左右兩側,而舞蹈的動作幅度通常發生在左右方向,最先犧牲的就是伸出去的手與跨出去的腳。
延伸閱讀
如果你正要從靜態照片開始,先讀如何把照片變成影片,那裡談的來源照片原則可以直接套用在舞蹈上。動作描述的部分,AI 影片提示詞指南有更完整的結構說明;至於為什麼 9:16 會改變模型能留在畫框內的範圍,影像比例與多重輸入有專門解釋。
想直接用自己的照片試試看,可以從範本頁挑一個開始。
想拿自己的照片先把這套規則驗一遍,可以打開舞蹈範本工具:上傳一張全身照、跑一條 5 秒,看你的照片到底過不過關。