ai视频生成做舞蹈视频:一张全身照让人物在画面里跳起来
ai视频生成做舞蹈,决定成片的不是提示词写了多少字,而是四个参数有没有先定死:源图全身入框、机位锁住、时长压在 5 秒、画幅按平台先选。这篇把四个参数拆成可执行的具体取值,附三条路线对照表、四个平台的画幅时长表和交付前自查表。
本页目录
# ai视频生成做舞蹈视频:一张全身照让人物在画面里跳起来
ai视频生成最能看出一个图生视频模型的功底——跳舞片段正是它展示能力的地方。人物动得多,模型要补的帧就多,所以一段片子能否站住,取决于源图和提示词有没有给它足够扎实的依据。这两件事做对,五秒的干净动作就只是参数问题。
问题不在模型,在参数。这篇按国内做号的顺序写:先确认路线,再定源图和机位,接着把时长、分辨率、画幅钉死,最后才写提示词。每一步都给具体取值,照着填就行。
三条路线:先确认你手上有什么
名字都叫 ai视频生成,底下的实现差别很大。先认清你用的是哪一种,后面的参数才有意义。
单图生成动作。 一张静态照片进去,模型自己编出动作。脸和身体来自你的照片,动作是生成的。这条路线门槛最低,手上只有一张照片也能做,稳定性全靠源图和参数——所以下面几节基本都是在服务这条路线。
模板映射。 工具里存着真实拍摄的动作素材,把你的主角贴上去。动作是真素材,接触关系、重心、节奏都是对的,稳定性明显高一档;代价是只能用库里有的动作,而且你的照片得塞得进模板的取景框。
成品视频改画风。 你本来就有一段舞蹈视频,只换人物长相或画风。三者里最稳,但手上只有照片的话走不了。
| 路线 | 输入 | 动作从哪来 | 稳定性 | 什么时候用 |
|---|---|---|---|---|
| 单图生成 | 一张全身照 | 模型逐帧生成 | 中,吃源图和参数 | 手上只有照片,要快速出片 |
| 模板映射 | 一张照片 + 库内动作 | 真实拍摄素材 | 高 | 要特定舞种、特定节奏 |
| 视频改风格 | 一段现成视频 | 原视频 | 最高 | 已有素材,只换人 |
大部分搜索落在第一条。预期就按这一类定:单图生成的演示片很好看,要真正做成能发的片子,得按它的规律来。
源图:全身入框是硬条件,不是建议
源图是唯一没法在生成之后补救的输入,构图错了,提示词写得再准也只能在错的框里折腾。七条硬标准,逐条都有原因。
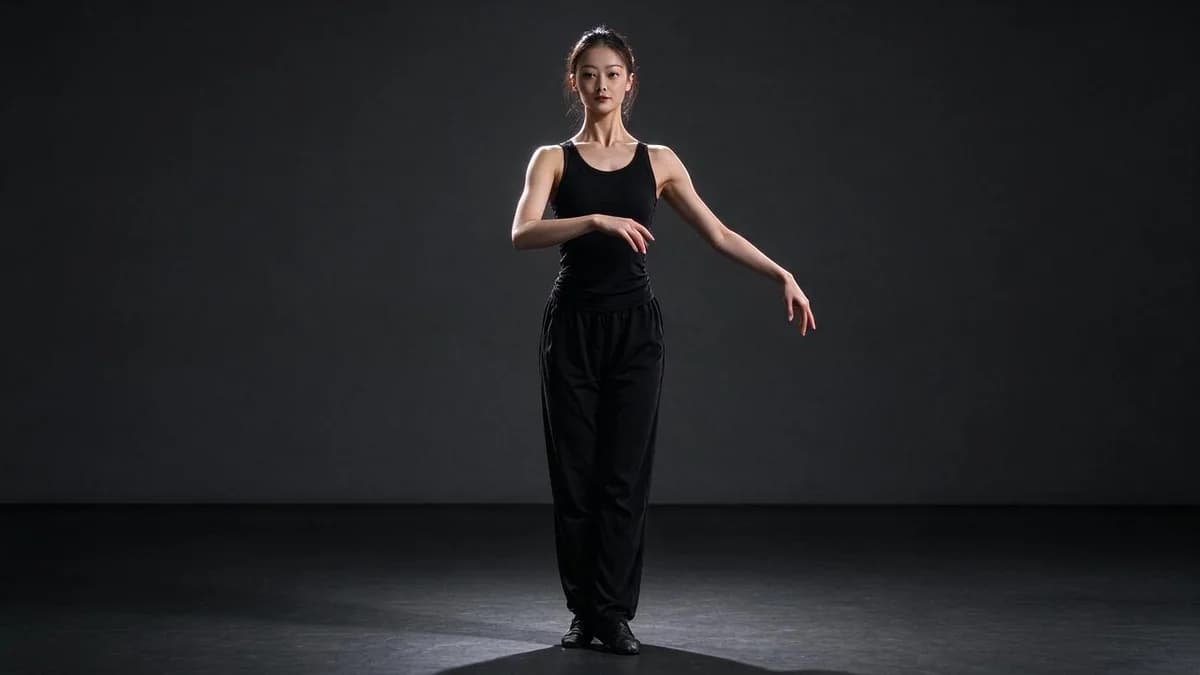
一、脚必须在画面里。 舞蹈的说服力有一半在脚下——踩点、踏步、起跳都靠它。裁到膝盖的照片,动作只能围着上半身转,看着像在挤早高峰。
二、头顶留 8%–10%,脚下留 5%–8%。 模型为了让动作有地方发生,会自动往外重新构图,边距不够它就把画面推出去,而推出去的第一样东西就是脚。
三、手臂离躯干 30–45 度。 手臂贴着身体时,模型分不清哪块是手臂哪块是腰,重叠的地方全得靠猜;手臂抬开,要猜的面积就小了。
四、背景要“没事发生”。 纯色墙、天空、大面积虚化都行。花纹墙纸、货架、人群、树枝容易被当成跟人物一起运动的东西,人物一动,要跟着重算的东西就多一份。
五、光线正面均匀。 侧逆光会在脸上压出大片硬阴影,阴影一旦被当成五官的一部分继续画进去,整张脸就跟着走样。室内窗光或柔光灯正面补一点,比调任何参数都管用。
六、短边至少 1000 像素。 手机原图直出基本都够,聊天软件里转存过的压缩图通常不够——放大看睫毛和发丝边缘,糊了就是糊了。
七、衣服用纯色或大色块。 大格子、细条纹、密集印花在运动里最容易“沸腾”,图案会自己往上爬。
机位:第一版一定锁死
运镜和动作是两个独立变量,同时动就是同时解两道题,而模型只擅长解一道。第一版统一写“固定机位”,等动作干净了,再考虑加一点缓慢推近。
锁机位还有个隐性好处:画面边框不动,人物出框与否一眼就能看出来,自查成本降一半。反之,镜头一推,人物在画面里的比例一直在变,你很难判断问题到底出在动作还是出在运镜。
具体写法就是四个字:固定机位。别写“轻微手持”“缓慢环绕”,那类描述在静态转动态的场景里只会让边缘抖动放大。
时长、分辨率、画幅:三个数字先定死
时长。 5 秒是甜点区:动作起势、发生、收住,刚好在一个呼吸里完成。10 秒等于让同一套设置多撑一倍时长,所以长片应该建立在“这条 5 秒已经站住”的基础上,而不是一上手就拉长。想发长内容,把几条 5 秒接起来,比一条 10 秒从头稳到尾容易得多。
分辨率。 720p 用来验构图和动作,确认没问题再出 1080p。竖屏刷手机 720p 勉强够看,但只要画面里要压字幕,就得 1080p。
画幅。 9:16 竖屏、1:1 方形、16:9 横屏三种都要在生成前选定,不要用 16:9 生成再裁成 9:16——裁掉的第一样东西就是脚,而脚通常正是重点。1:1 适合人物居中的单人中景,横竖都能发,但两侧的动作会被切掉。
| 平台 | 画幅 | 建议时长 | 落地要点 |
|---|---|---|---|
| 抖音 | 竖屏 9:16,1080×1920 | 5–8 秒 | 前 2 秒要有动作起势,别让开头站着 |
| 小红书 | 竖屏 9:16 或 3:4 | 5 秒 | 单独出一帧当封面,别拿视频首帧凑 |
| 视频号 | 竖屏 9:16 | 5–10 秒 | 首帧干净,分享卡片才好看 |
| B 站 | 横屏 16:9,1920×1080 | 8–10 秒 | 横屏信息多,适合把两三段接起来 |
还有一条经验:动作幅度越大,能稳住的秒数越短。原地轻摆撑满 5 秒还有余量,连续转身 5 秒就到顶;想更长就把几条 5 秒接起来。表里的时长按成片算,生成仍走 5 秒、10 秒两档。
提示词:五段式,一段只放一个主动作
提示词的结构其实很朴素,五段往后排:主体 + 动作 + 幅度 + 机位 + 取景。按这个顺序写,比堆一百个形容词有用。
可以直接抄的五条:
- 小幅度律动:人物左右轻摆,肩部放松,双脚原地不动,固定机位,全身在画面内
- 嘻哈踩点:人物做两步踩点,手臂在体侧自然摆动,机位锁定,全身入框
- 原地转身:人物转身 180 度后停住,头发跟随转动,固定机位,全景
- 双人同步:两人同步踏步,两人都在画面内,固定机位,全景
- 小朋友跳舞:幼儿原地轻轻弹跳,双手举起,固定机位,全身可见
三条写法上的规矩:
一是永远写机位。 “固定机位”四个字的作用,比任何风格词都大。不写机位,模型会默认给你一点运镜,而运镜和动作叠加就是双重难题。
二是永远写取景。 “全身在画面内”“全景”“两人都在画面内”这类约束,模型真的会执行,它比“唯美”“电影感”“高级质感”有用得多——后面这些词不约束任何几何关系,只会把画面往更密、更花的方向推。
三是负面约束单独放一句。 比如“不要出框、不要额外的手指、背景保持静止”。别把“不要”混进主描述,主描述只写你要什么。
五个现象:出现了按这条改
脚出框。 模型为了容纳动作重新构图了。改法:源图拍得比需要的更宽,或提示词里明确写“全景、全身在画面内”。
脸部漂移。 身份信息随帧数衰减,头部快速转动时最明显。改法:让头部相对稳定,时长压到 5 秒,避开把脸转离镜头的大侧脸。
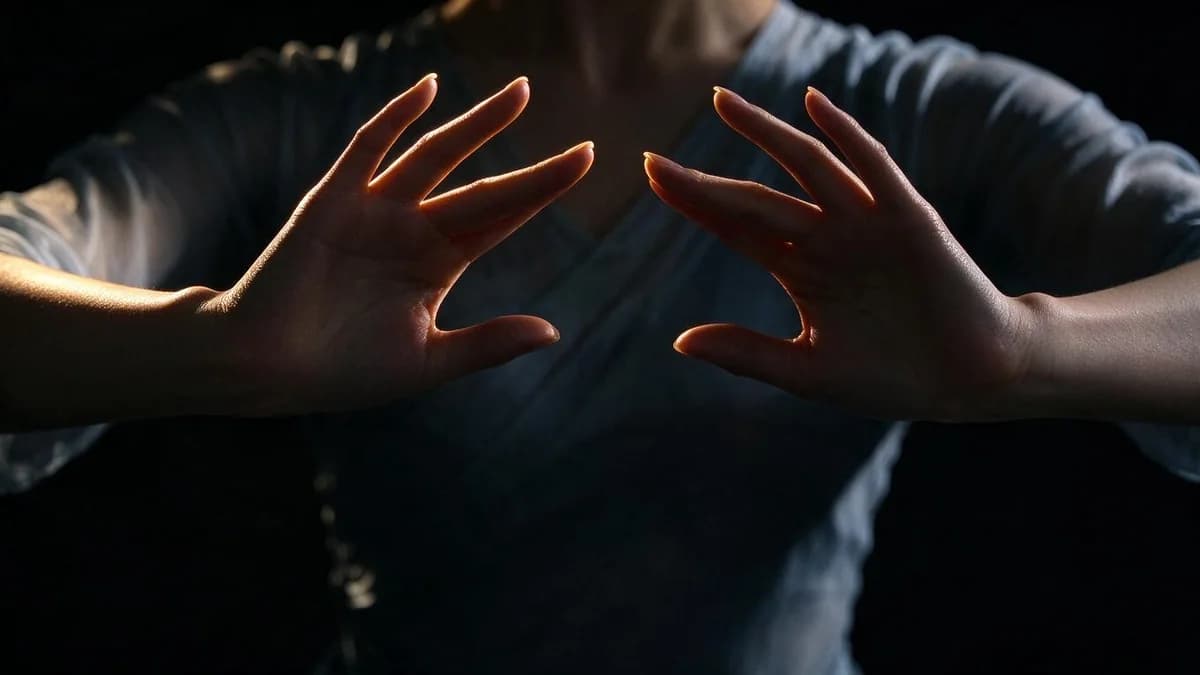
多指、双手糊成一团。 手靠近躯干或互相交叠是经典触发条件。改法:选手臂与身体之间有明显缝隙的姿势,两只手分开。
背景融化。 背景越复杂越容易跟着人走。改法:纯色墙、天空、强虚化。
橡皮肢体。 长距离、高速度的动作超出模型能跟踪的范围。改法:缩短时长、减小幅度,一条只做一个动作。
这五条全部在你点生成之前就决定了。所以源图和提示词的分量才这么重——干净的第一条片子,靠的就是输入本身。
交付前自查
| 检查项 | 合格标准 | 不过怎么办 |
|---|---|---|
| 首尾帧 | 两头干净,能定格当封面 | 改时长、换起手姿势重出 |
| 脚 | 全程在画面内 | 源图拍更宽,或写“全景” |
| 手 | 手指数量正确,两只手分开 | 换手臂离躯干的源图 |
| 脸 | 全片是同一个人 | 压时长、避开大侧脸 |
| 背景 | 不跟着人流动 | 换纯色墙或强虚化 |
| 画幅 | 与目标平台一致,字幕区没被压 | 在目标画幅里重新生成 |
| 动作 | 只有一个主动作 | 拆成两条 5 秒 |
七项全过就能发。哪一项没过,回到对应小节改那一项输入,别在同一条片子上反复磨。
FAQ
一张照片就能做舞蹈视频吗? 能,结果由构图决定。全身入框、脚在画面内、背景简单,这三条做到就有戏。裁过的半身照会把动作锁在上半身。
做多长合适? 从 5 秒起步,取景稳住了再上 10 秒,两档都要锁机位。
为什么脸会在中途变样? 头部快速转动和大侧脸是身份最难保持的地方。让头部稳定、把时长压短,这两件事一起做。
一定要用模板吗? 不一定。模板给你真实动作,但只能用库里的东西;提示词驱动的路线更灵活,也更依赖你把参数写对。
发抖音用什么画幅? 竖屏 9:16。用 16:9 生成再裁,裁掉的就是脚。
分辨率从哪档开始? 720p 验构图和动作,确认站住了再出 1080p。要压字幕的内容直接上 1080p。
下一步
从静态照片起步,先看怎么把一张照片变成视频,那里的源图规则在舞蹈上完全适用。动作描述怎么写,AI 视频提示词指南讲得更细;为什么 9:16 会改变模型能保住的东西,看画面比例与多图输入。
想直接上手,打开模板页,从一张静态照片开始。
想拿自己的照片先把这套规则验一遍,可以打开舞蹈模板工具:传一张全身照、跑一条 5 秒,看你的照片到底过不过关。