图生视频做拥抱亲吻特效:两张照片先对上,动作才站得住
图生视频做双人特效,先挑照片再定构图,最后才写提示词:两个人靠得越近、角度越一致、光越接近,接触那一刻就越像真的。这篇讲清单图与双图的取舍、必须对齐的四件事、以几何关系为核心的提示词写法,以及让两张脸在重叠时不融在一起的办法。
本页目录
# 图生视频做拥抱亲吻特效:两张照片先对上,动作才站得住
图生视频做双人特效,成败几乎全在输入照片上:两个人靠得越近、角度越一致、光越接近,接触那一刻就越像真的。模型要做的事其实很简单——让两个身体把距离收掉;难的是收掉距离的那几帧里,两套五官必须共享相邻的像素。
所以这类特效的顺序和大多数教程相反:先挑照片,再定构图,最后才写提示词。措辞能调气氛,调不了 40 度的角度差。
单图还是双图:先定输入方式
同样叫双人特效,输入方式决定了后面所有工作量。
单图输入。 一张已经包含两个人的照片。模型在一张画面里为两个身份各自编运动。这是最省事的路径,因为大多数情侣号手上本来就有一张合照;它也对输入最敏感,因为两张脸一重叠,输入里没有任何信息告诉模型哪张脸是谁。用这条路,源图里两个人本来就得靠得近——挨着肩、头靠头、贴着脸,都属于好起点。
双图输入。 一人一张,模型先把两张照片合成到同一个场景,再让它动。身份保持好得多,因为每张脸都来自自己的源图;代价是合成这一步会带来新问题:光线不一致、比例不一致、背景得凭空造。
模板动作。 库里存着真实拍摄的拥抱或亲吻素材,把主角映射上去。真实动作意味着真实的接触关系,成片连贯度最高;限制是只能用库里的角度和取景。
判断标准很直接:手上是合照就走单图,是两张单人照就走双图,要某个很具体的接触动作就走模板。如果某个工具说不清自己在做哪一种,那它多半是第一种。
四件必须先对齐的事
双图输入的质量,全看这四项对齐得怎么样。单图输入同样适用,只是它天然已经对齐了一部分。
角度。 两张都是正面平视最稳。一张正一张侧,模型会把侧的那张转过去对齐,五官跟着走形。
光位。 光从哪边来、软还是硬,两张要一致。一张窗光一张顶灯,合成之后一个人脸上是高光、一个人脸上是阴影,接缝一眼可见。
色温。 色温差一点,单看各自都不觉得,合成之后一个人偏黄、一个人偏白,观众第一反应就是“P 的”。做不到同场景同光源,就把两张的色温和亮度手动调到一致再传。
头部大小。 以眼睛到下巴的距离为基准裁到接近,比把两张图缩放到一样高可靠得多。头部差 10%,观感上就是“这俩不是一张图里的人”。
| 输入的问题 | 画面里会看到什么 | 改法 |
|---|---|---|
| 两张脸角度差太大 | 一张脸被转过去对齐,身份跑掉 | 换成两张都接近正面的照片 |
| 光位或色温不一致 | 一个人像被贴上去的 | 挑同一种光下拍的,或统一色调 |
| 有人被裁到肩膀 | 手臂靠模型编,通常编错 | 上半身完整,肩膀和手都在画面里 |
| 背景太乱 | 身体重叠时背景扭曲、闪烁 | 纯色墙、天空,或很重的虚化 |
| 手离脸太近 | 手指粘连、多指 | 选手放在低位或不在画面里的照片 |
| 分辨率太低 | 脸发虚,没有细节可保 | 短边至少 1000 像素 |
提示词:写几何和终点,不写气氛
提示词在这类场景里只有一个正确方向:把“谁在什么位置、往哪边动、动到哪停”写清楚。情绪词几乎不起作用——模型能执行位置,执行不了气氛。
| 想要的效果 | 提示词写法 |
|---|---|
| 轻轻靠近 | 两人向对方倾身并相拥,手臂环过肩膀,固定机位,两人都在画面内 |
| 重逢 | 人物从画面左侧跑入并拥抱对方,固定机位,全片两人都可见 |
| 额头相抵 | 两人同时低头靠近,直到额头相触,停住,固定机位,近景 |
| 克制的一吻 | 两人靠近,轻触嘴唇后分开,固定机位,两张脸都在画面内 |
| 静抱不动 | 两人保持拥抱,只有轻微呼吸起伏,固定机位,两人都在画面内 |
三条规则承担了大部分工作。
写明终点状态。 “直到额头相触”比“深情地”可靠得多。终点是一个位置,位置可以执行。
锁死机位。 接触期间任何运镜都会放大重叠误差,横移和推近尤其明显。固定机位是这类片子的默认值,不是可选项。
写明谁必须在画面里。 “两人都在画面内”是模型真的会遵守的约束。不写这句,它有可能在接触瞬间把其中一个人挤出边框,而那一刻正是整条片子的重点。
另外,别堆形容词。“浪漫、温柔、电影感、有情绪的拥抱”给了模型四个互不相关的约束,却没给任何几何信息。想让它好看,先把位置写对。
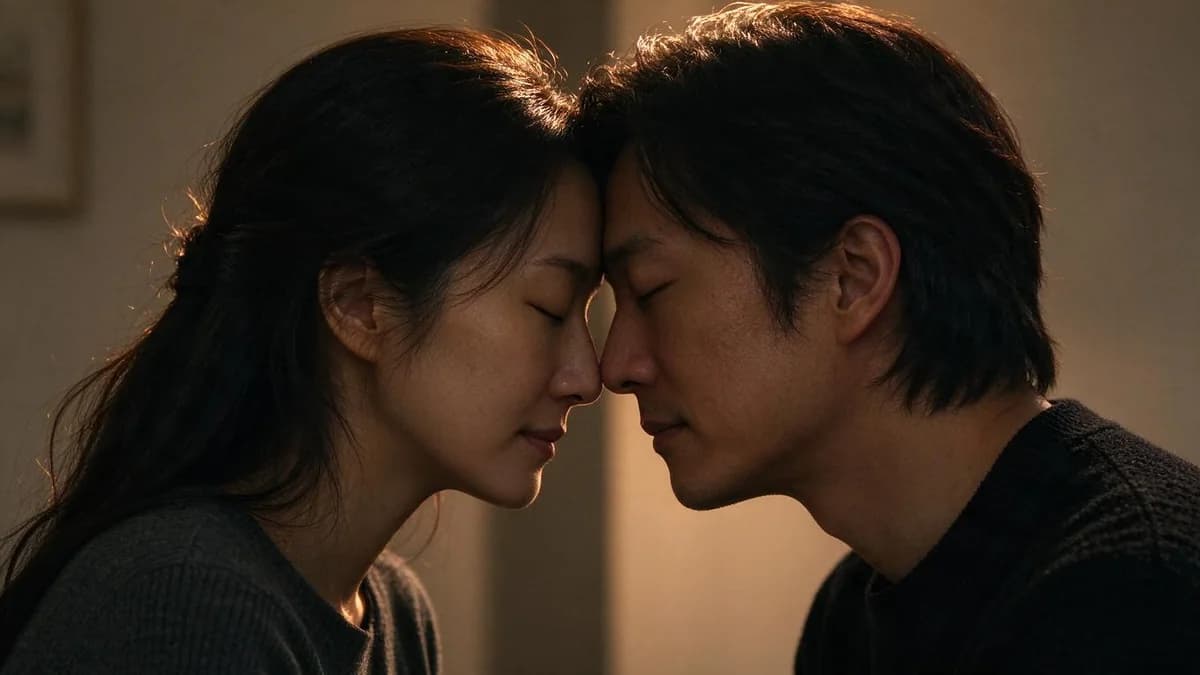
让两张脸不糊在一起
两张脸会在两个身份共享相邻像素、并持续好几帧的时候糊在一起。三件事能挡住它,按有效性排序。
一、从两人本来就靠得很近的照片开始。 源图里两张脸已经相接,模型只需要挪几毫米,几乎全部难度都消失。
二、用带真实接触关系的模板。 拍好的拥抱素材里,两个身体怎么贴合已经是现成的答案。
三、把片子压短。 5 秒比 10 秒少一半需要身份在重叠中存活的帧。
手是同一套逻辑:要么让它简单,要么让它出画。一只手搭在脸颊上是最该先简化的镜头——手指贴着脸,等于让模型同时处理两套曲线边界,指缝和下颌线会一起糊。把手放低到肩膀或手臂上,问题立刻减一半。
构图与画幅:三种摆法,三个比例
面对面。 最自然,也最考验角度一致。身高差太大时,会有一方被抬起来或压下去,脚和肩膀最先露馅;让矮的一方站前半步,视觉上就平了。
半侧身,约 45 度。 重叠面积比正面小,脸部还留着各自的轮廓,是双人接触里最稳的一种。想要自然、五官又清楚,优先选这个。
并排同向。 适合“搂肩”“靠头”这类动作,16:9 更舒服,因为横向要放两个人。
画幅上还有一条:9:16 竖屏适合发抖音、小红书、视频号,但两个人并排时横向空间很挤,接触动作容易被压到画面外;16:9 横屏给得开,B 站和横版封面更合适;1:1 只在脸部特写时才顺手。所有比例都在生成前选定,别用 16:9 出了再裁。
取景范围也要一起定:接触类镜头通常给到上半身或七分身,脸和手都在画面内;只有在两人并排站立、要表现身高差时,才用全身入框。全身入框时,脚同样要留在画面内,别让画面切在脚踝上。
五步工作流
- 准备两张角度、光位、色温都匹配的照片,裁到头部大小一致。
- 先在 5 秒上把接触瞬间跑出来,720p 验构图,别一上手就上 1080p。
- 只用一条标准判断:接触那一刻像不像真的。脸糊在一起,就换源图,不要改提示词。
- 有一条站住了,再用 1080p 重跑同一套设置,机位依旧是固定的。
- 把这对源图存好,同一个组合能反复用。
顺序很重要:片子不对,先换照片,再改提示词。角度差太大这个问题,没有任何措辞能补回来。
FAQ
一张照片能做拥抱视频吗? 能,而且是最常见的做法。双图对身份保持更好;单图则要选一张两人本来就挨得近的照片,成片才清晰。
为什么两张脸会融到一起? 因为两个身份在没有分别控制的情况下共享相邻像素好几帧。换一张更近的源图,或者用带真实接触动作的模板。
做多长? 5 秒。10 秒要求两张脸在更多帧里保持一致,先在 5 秒上站住,再考虑加长。
侧脸能做吗? 能做,但要两张都是同方向、同角度的侧脸。一张正一张侧,模型会把其中一张转过去对齐,五官就走形。
用什么画幅? 社交平台用竖屏 9:16;两人并排、需要横向空间时用 16:9;只有脸部特写才用 1:1。
分辨率怎么取? 720p 先把接触瞬间和构图验出来,确认可信再出 1080p。脸部的细节在 1080p 才留得住。
下一步
怎么把照片变成视频里的源图规则在这里直接适用;动作描述怎么写才能撑过好几帧,看AI 视频提示词指南。如果你的需求是把某个人物替换进一段现成素材,而不是从零生成,用模板替换视频人物更对路。
想用自己的照片试,打开模板页。
本文这些条件,可以拿一张照片在图片转视频工具里当场验:先跑 5 秒一条,看主体和构图撑不撑得住,再决定要不要往下做。