ai视频教程:先看清手上有什么,再决定走哪条路
ai视频教程最容易走偏的地方,是一上来就挑工具。真正该先回答的是:你手上是文字、一张照片,还是一段参考动作?三种输入对应三条路,参数和坑都不一样。这篇给一张路线对照表、一条第一支片子的完整走查,以及真正需要调的五个参数。
本页目录
# ai视频教程:先看清手上有什么,再决定走哪条路
ai视频教程最该先回答的一件事,不是哪个工具好用,而是你手上有什么。市面上的生成器只吃三种输入:一段文字描述、一张静态照片、一段参考动作。三种输入对应三条完全不同的路,参数不一样,容易出问题的地方也不一样。
这篇当地图用。三条路各讲到能上手的程度,再带你把第一支片子从头到尾走一遍。提示词怎么写、单张照片怎么挑,这两块各有专篇,文末导出去,这里只讲够用的部分。
先按“手上有什么”选路
选路只有一个判断标准:你要的画面里,有没有必须被认出来的东西。 有,就不能纯靠文字;没有,文字反而是最省事的入口。
三句话对号入座:
- 手机相册里翻得出一张能用的照片 → 图生视频。
- 只想要一个氛围、一个空镜,画面里没有具体的人 → 文生视频。
- 手里有一段现成的动作或运镜,想套到自己的主体上 → 模板动作。
| 判断句 | 走哪条 | 你实际会拿到 | 什么时候别走这条 |
|---|---|---|---|
| 相册里有一张主体清楚的照片 | 图生视频 | 照片里的那个人或那件东西动起来 | 照片裁得太紧、光线太暗,先重拍 |
| 画面里不需要出现具体的人 | 文生视频 | 模型完全编出来的一段画面 | 一旦要固定某张脸或某个商标,这条路就到头了 |
| 手上有一段动作想复用 | 模板动作 | 真实动作套到你的主体上 | 模板角度和你的照片差太多,映射会歪 |
| 要按脚本出很多条 | 文生视频,按镜头拆 | 在剪辑软件里拼成一条 | 镜头之间的连贯性没人替你兜底 |
绝大多数问“怎么开始”的人,手机里其实已经有一张照片——那就是第二条路,也是出片最快的一条。
路线一:文生视频,从一句话开始
你描述一个场景,模型把它画出来。你手上没有任何素材约束输出,这既是它好用的地方,也是它的边界。
适合:空镜、风景、天气、抽象运动、远景人群、氛围镜头。判断标准很简单——画面里没有需要被认出来的具体对象。
一句能直接用的描述长这样:
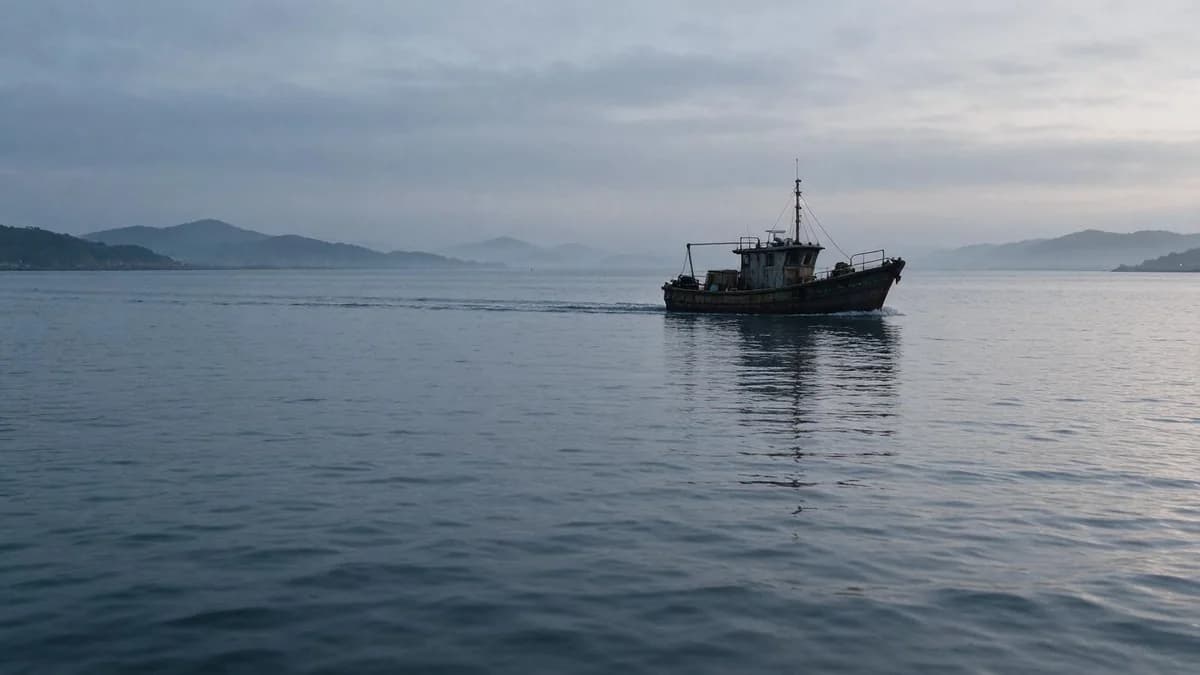
清晨灰蓝色的港口,一艘渔船缓慢横穿画面,镜头轻微前推,阴天散射光,画面稳定。
这类描述成立的原因,是画面里没有一张需要被认出的脸。
不适合:你在意的人脸、招牌上的字、商标、精确到指节的手部动作、同一个角色连着出好几个镜头。让模型画两次“同一个人”,你会拿到两个不同的人。
写法上只有两条是硬要求,另外两条是省事的技巧。
硬要求一:机位写成动作,不写形容词。“缓慢前推”“从左向右横移”模型能执行;“电影感”不指向任何一个位置关系。
硬要求二:一句话只挂一个动作。 5 秒只够一件事发生,写两件等于两件都看不清——想加第二个动作,就再出一条。
省事技巧:光源先写,句子短。“傍晚侧逆光”“左前方一盏台灯”比“氛围感光线”有用得多;主谓宾齐全的短句,比长从句更少被忽略。
路线二:图生视频,把已有照片动起来
这条是主力路线。输出的构图、长相、光线都继承你给的照片,等于把可控的部分提前锁住了。
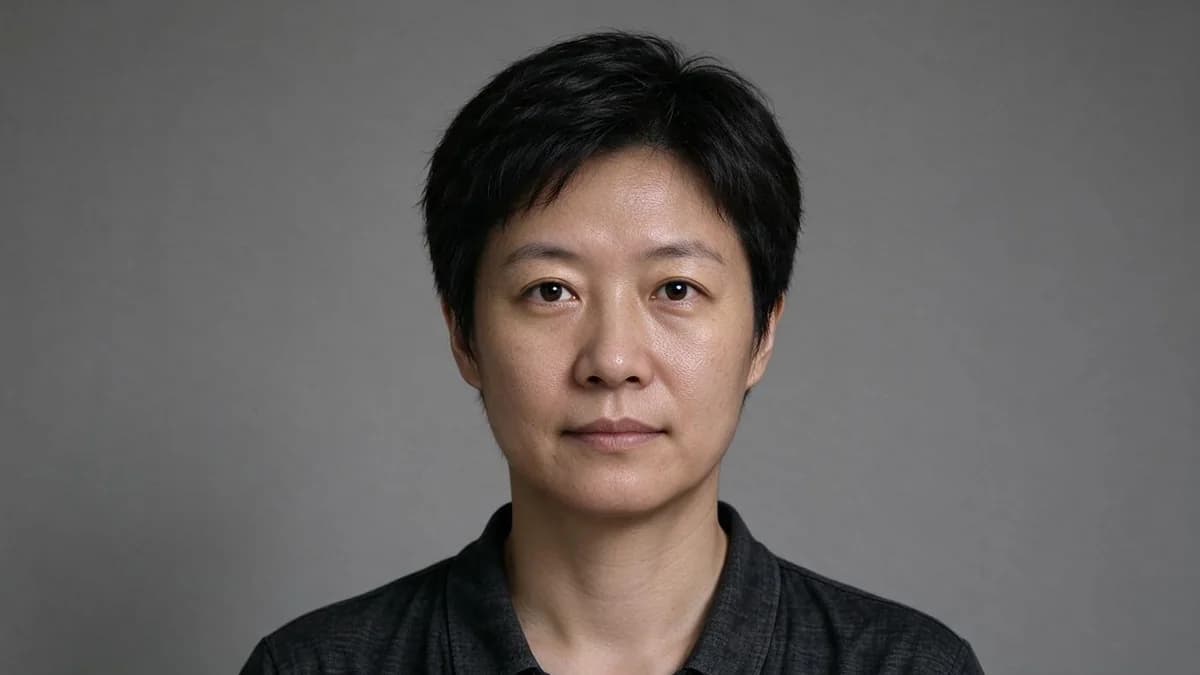
一条总纲:源图决定上限。 一张正面、光匀、四周有余量的照片,交给哪个模型都能出干净片子;一张昏暗、歪斜、裁得很紧的照片,提示词写得多细都补不回来。
选图只有三条硬门槛,细节留给专篇:
- 短边至少 1000 像素,分辨率低时先糊的是脸。
- 主体完整入框,运动方向留出空间。 拍全身就拍到脚,全身入框,别让画面切在脚踝上。
- 背景干净或虚化,补光要正面,别让硬阴影压在脸上。
写动作,不写情绪。模型要知道的是“什么在动、动多远、镜头动不动”:
人物头部向左轻转并微笑,固定机位,上半身入框。
这是规格。“唯美、有生命力、有情绪”不是规格。
要更细的选图规则,看怎么把一张照片变成视频;动作句怎么写得扛住多帧,看AI 视频提示词指南。这两块本篇不展开,避免和专篇重复。
路线三:模板动作,把真实动作套到自己身上
你不描述动作,而是给一段参考视频,模型把你的主体映射到那段真实运动上。编舞、走位、某个说不清的运镜、一个很难用文字描述的手势,都归这条。
模板解决的是文字描述解决不了的那件事:真实的接触关系。两个人的拥抱素材里,手臂放在哪、身体怎么贴合,帧里已经写好了;纯靠文字描述,模型只能猜。
代价在取景。模板是在特定角度、特定距离、特定机位下拍好的,你的照片得接近那个取景,否则映射会变形。生成前查三件事:
- 朝向是否一致:模板里人朝左,你的照片也别朝右。
- 裁切是否接近:半身模板配半身照片,别拿大头照硬套。
- 模板要求的全身是否在你帧内:模板是全身构图,全身入框,脚就别让它被裁掉。
输出发软、发飘的时候,先怀疑取景对不上,别急着改提示词——这是这条路上最常见的原因。
真正需要调的五个参数
参数表很长,但真正决定成片可用与否的只有五个。
| 参数 | 控制什么 | 起步值 |
|---|---|---|
| 时长 | 一个错误要扛多少帧 | 5 秒;站住之后再上 10 秒 |
| 分辨率 | 细节,以及试错的成本 | 720p 起草,1080p 交付 |
| 画幅 | 能发到哪、模型要补多少边 | 9:16 竖屏、16:9 横屏,1:1 只给脸部特写 |
| 机位 | 有多少画面需要重新画 | 固定机位,最后才考虑加运动 |
| 运动幅度 | 主体在画面里走多远 | 小;第一版普遍给得太大 |
五行的规律是同一条:先给模型最少要编的东西,再一次加一个自由度。 固定机位先于运动机位,5 秒先于 10 秒,小幅度先于大幅度。这条顺序反过来,你会同时在五个方向上排查问题。
四个去处,三种画幅
画幅别等出片之后再想,那是最常见的一小时浪费。
- 抖音、视频号:竖屏 9:16。主体要有头顶空间,动作落在画面中段,别贴边。
- 小红书:9:16 或 3:4,封面单独出一帧,别拿视频首帧凑。
- B 站:横屏 16:9。横屏信息多,适合把两三个镜头接起来。
分辨率跟着去处走:手机上看,720p 够判断;要发布,1080p 起步——别把草稿放大凑数。
串一遍:第一支片子分三段跑完
参数和画幅都定完,拿一张你不太在意的照片练手。整件事分三段,别一口气全做完。
第一段,点生成之前把三件事定死。 这三件定完,后面省下的时间远不止几分钟。
- 照片:正面、光匀、主体居中、头顶留白,四周有余量。
- 画幅:按发布的地方先选,别出完再裁。
- 时长:5 秒。10 秒等于把每一帧的负担翻倍,第一版不碰。
第二段,只跑一次,只写一句动作。 主体 + 动作 + 方向 + 机位,机位写“固定机位”,形容词全省。分辨率用 720p——这一版是拿来判断的,不是拿来发的。
第三段,连看三遍,然后只动一个变量。
第一遍看是不是同一个人;第二遍看动作走完没有、有没有中途停住;第三遍看有没有东西进出画面。发现问题就对应改一处:身份飘换源图,动作过头缩句子,背景流动简化背景。改完再跑,仍然只改一处。
站住之后,同一张图、同一句话、同一时长,只把分辨率换到 1080p 重跑一次。跑完把源图、动作句、参数记进一个文件,下次改一个字就能复用。
FAQ
第一支片子要多久? 照上面三段跑一遍,十到十五分钟,包含挑照片的时间。大部分时间花在做决定,不在等生成。
没有照片,只有一个想法,能开始吗? 能,走文生视频。前提是画面里不需要出现某个具体的人——需要具体的人,就得先有一张照片。
画面技术上没问题,但看着还是假,为什么? 多半是光。生成画面默认是平的、没有方向的散射光,写清光源和方向,观感提升比改任何其他参数都明显。
一条片子能做更长吗? 能,但秒均质量会往下走。可靠的做法是几条 5 秒分别生成,在剪辑软件里接起来。
画幅会影响质量吗? 会,但两种损失不一样。拿横构图源图去出 9:16,上下多出来的部分得由模型编;反过来先出 16:9 再裁成竖屏,丢的是左右两侧,脚也常被切掉。所以一开始就让源图和输出同向。
五个参数里先调哪个? 时长。短片里其他问题都好改。
下一步
从照片起步,怎么把一张照片变成视频讲选图;动作句怎么写,AI 视频提示词指南讲结构。想知道静图里哪些部分真的能动,看怎么把照片变成视频:静图能动到什么程度。要让动作来自参考素材而不是描述,用模板替换视频人物讲映射流程。
想直接上手,打开模板页,用一张照片出一条 5 秒。
本文这些条件,可以拿一张照片在图片转视频工具里当场验:先跑 5 秒一条,看主体和构图撑不撑得住,再决定要不要往下做。