ai动作控制:让一段现成的动作,落到你自己的照片上
ai动作控制解决的是「动作从哪来」这件事:不是你写一句话让模型猜,而是给一段参考视频,让它把里面的动作搬到你的主体上。能否搬成功,八成取决于这段参考视频够不够干净。这篇给一份参考视频可用性检查表、源照片的五条门槛,以及动作幅度的分档。
本页目录
# ai动作控制:让一段现成的动作,落到你自己的照片上
ai动作控制要解决的是“动作从哪来”这件事。写一句话让模型自己编动作,是最常见也最不听话的做法;换一条路——给一段参考视频,让它把里面的动作搬到你的主体上——动作就有了出处,节奏、重心、手脚的先后顺序都是现成的。
所以这一类玩法的成败,大半不在提示词,而在你挑的那段参考视频够不够干净。
动作是“读”出来的,不是“想”出来的
参考视频进来之后,模型做的是三件事:认出画面里那个人是什么姿势、这个姿势怎么随时间变、再把这条变化轨迹套到你给的照片上。
这条链路里,任何一环信息不足,都会变成成片里的毛病:
- 参考视频里人被挡住一半,模型读不到被挡的那条腿,只能补一个大概的姿势;
- 参考视频是低机位仰拍,比例已经被拉过一遍,套到正面源图上就对不上;
- 参考视频自己就在晃,动作轨迹里混进了镜头晃动,主体跟着一起飘。
理解了这三件事,检查表就好写了:你要的是“一段干净的、全身可见的、机位不动的动作”。
参考视频可用性检查表
按顺序过一遍,六项都过再动手。哪一项不过,第三列就是可以马上换的做法。
| 检查项 | 合格标准 | 不合格怎么办 |
|---|---|---|
| 人数 | 画面里只有一个主体在动 | 裁掉其他人,或换一段单人素材 |
| 取景 | 全身入框,脚和手都在画面内 | 换一段拍全的;半身素材只能驱动上半身 |
| 遮挡 | 动作过程中手臂不长时间压住躯干 | 换一段手臂张开的动作 |
| 机位 | 全程固定机位,没有推拉摇移 | 换素材;或先在剪辑里把镜头晃动稳住 |
| 清晰度 | 主体轮廓干净,没有明显运动模糊 | 换更高清的素材,模糊会直接传给成片 |
| 时长 | 5 秒或 10 秒的一段完整动作 | 剪出一段动作完整的片段,别半截掐断 |
六项里最容易被忽略的是“遮挡”。手臂横过胸前、抱住自己、双手插兜,都会让模型在关键帧上失去那条手臂的位置,接着它就会在两帧之间“猜”一个过渡姿势。猜出来的过渡,就是成片里最假的那半秒。
源照片要满足什么
参考视频决定“动作”,源图决定“是谁在动”。后者有五条门槛。
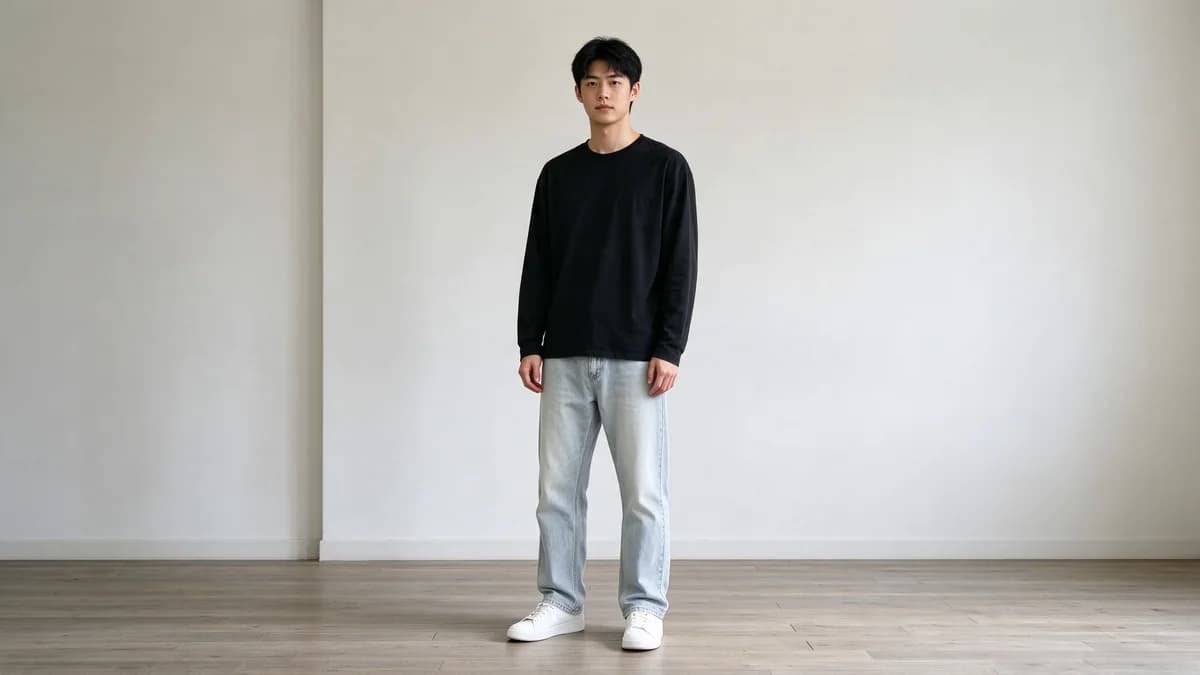
一、全身入框。 要驱动全身动作,源图就得有全身——照片裁在腰上,动作再完整,下半身也只能靠编。
二、正面或接近正面。 侧身 45 度以内还行;纯侧脸配正拍动作,朝向会对不上。
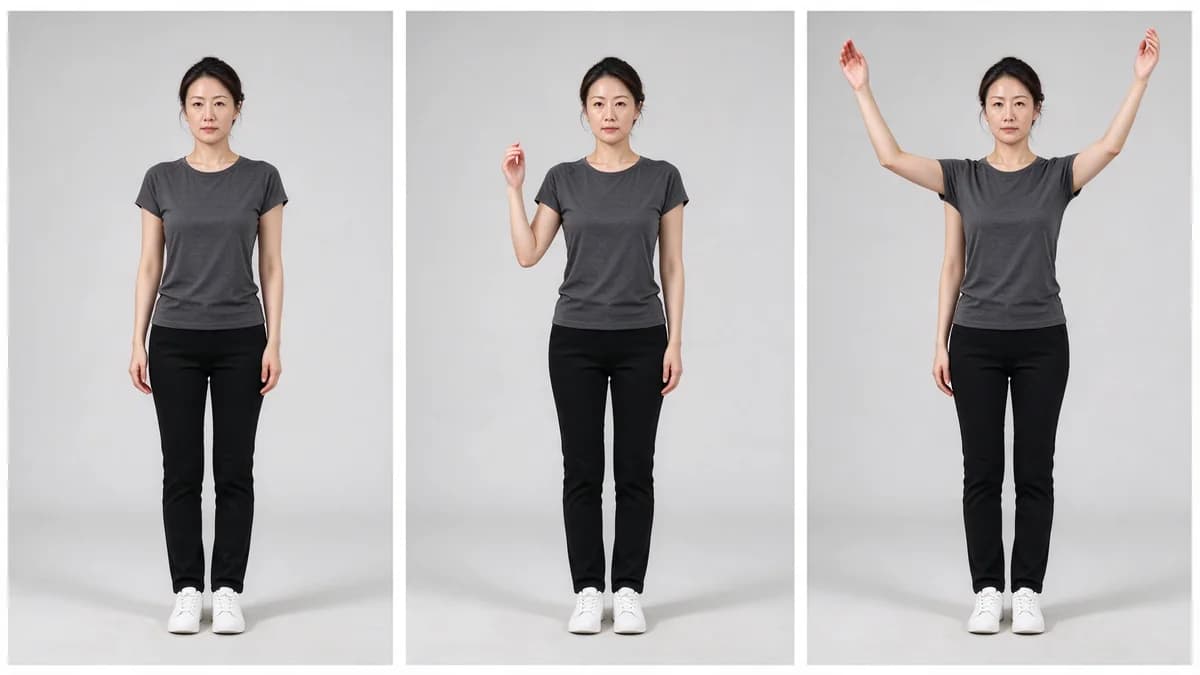
三、四肢和躯干分得开。 手臂贴身、双腿并拢,等于把可动的部位并成了一块。手臂离躯干 30 到 45 度,是最省事的起手姿势。
光线和清晰度这两条是配套的:光照方向要接近参考视频,两边光从相反方向来,搬到一起就是“贴上去的人”;短边至少 1000 像素,低分辨率下先糊的是脸,而脸是观众第一眼看的地方。
五条里最值钱的是第一条和第三条。同一段参考动作,换一张四肢分得开的全身照,出来的稳定程度明显不一样——这一步的收益比改十遍提示词都大。
动作幅度分三档,别一上来就顶格
参考视频里的动作有多猛,成片就有多难稳。按幅度分三档来安排,比一次做到位省事得多。
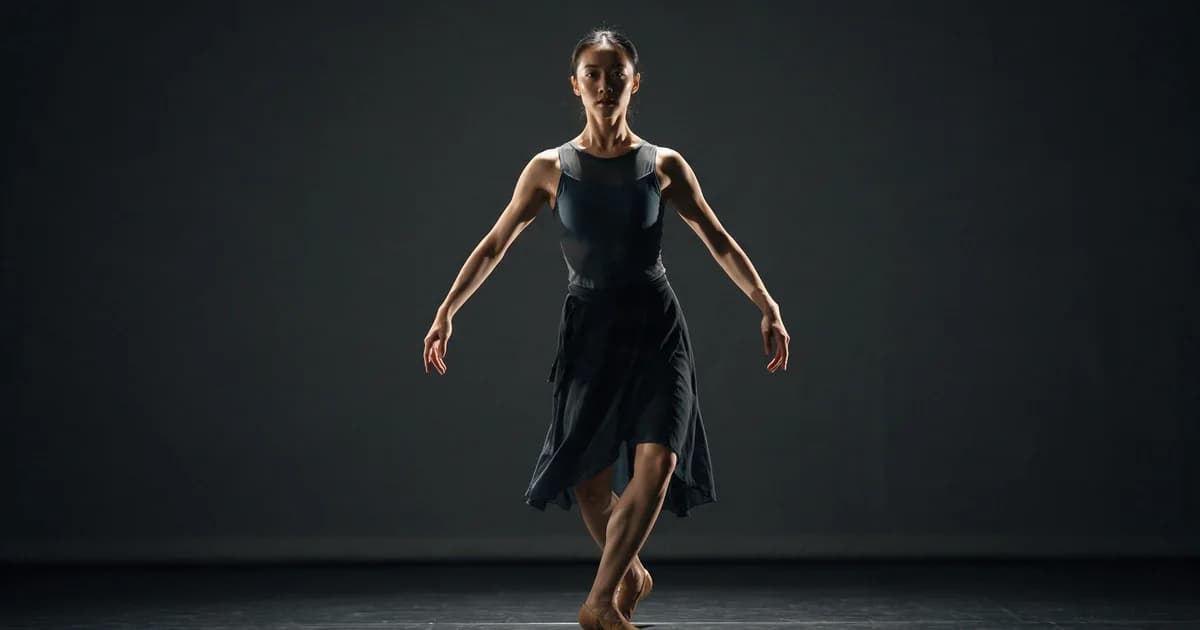
第一档,原地小幅。重心左右移、肩膀绕环、抬手放下、点头。这一档在 5 秒里最稳,也最适合第一次试:动作不离开原点,画面里没有需要新画出来的空间。
第二档,半身或半步。上身转体、迈半步、侧身让位。这一档要 5 秒,10 秒就开始在后半段松。
第三档,位移。走、跑、转身一周、跨步。这一档要求模型补出照片里没有的地面和身后的空间,10 秒基本撑不住,5 秒也要把动作剪短。
判断标准很简单:动作让主体离开原来的位置越多,能给的秒数越少。5 秒和 10 秒是两档固定值,别自己取中间值——需要更长,就把两段 5 秒接起来。
锁定机位为什么是前提
动作迁移里,画面里已经有一个大变量在动:主体。这时候再让镜头动,模型要同时处理两套坐标系——身体在画面里移动,画面本身也在移动,两套叠在一起,边缘、脚底、地面接触点最先出问题。
所以第一版一律写“固定机位”。等动作站住了,再考虑要不要加一点缓慢推近;而且加了之后,动作幅度通常要往回收一档。
固定机位还有一个隐性好处:边框不动,主体偏没偏一眼就看出来,判断这条能不能用也快得多。
参数与画幅:先定,再生成
- 时长:5 秒起步,动作完整就够用;10 秒留给原地的小幅动作,或需要两个节拍连起来的段落。
- 分辨率:720p 起草,用来判断动作对不对;确认之后再出 1080p。别拿 1080p 试参数。
- 画幅:9:16 竖屏对应抖音、视频号、小红书;16:9 横屏对应 B 站;1:1 只留给半身或特写。动作迁移最怕裁切,因为裁掉的那部分正好是动作发生的地方——所以在目标画幅里直接生成。
参考视频从哪来
两个来源,各有取舍。
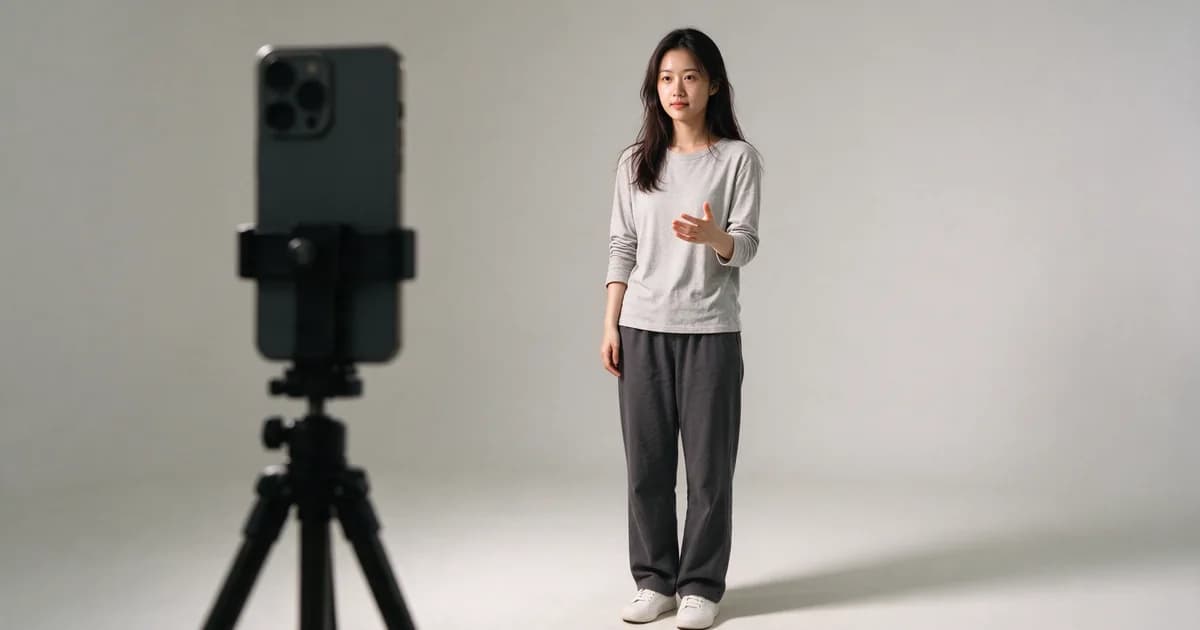
自己拍。手机就够用,关键是三条:把人拍全(全身入框)、机位固定(别手持跟拍)、光从正面来。拍 5 到 10 秒,动作完整,开头和结尾各留半秒静止,方便后期掐头去尾。
找现成素材。舞蹈、运动、手势类的素材不少,挑的时候只认一条:能否看清全身。远景素材看着大气,但人在画面里只占五分之一,动作读出来就是一团影子。
自己拍的好处是朝向、比例、光线都能和源图对上;找素材的好处是动作质量高,代价是要花时间筛。第一次试,优先自己拍——五分钟能拍完的一段,比翻半小时素材库更划算。
和相邻两件事的边界
站内已经有两篇讲相近的玩法,容易混,这里一次说清:
- 固定舞蹈模板:动作是库里现成的、挑好的,你只换人。适合“我就要一段爆款舞”。而这篇讲的是任意动作迁移——你找一段自己的参考视频,什么动作都行。
- 换人:把一段视频里的人换成另一张脸,动作和镜头都是原来的。而这篇是换动作:人是你照片里的人,动的是参考视频里的动作。
一句话记住:换人不动动作,换动作不动人。
FAQ
一定要有参考视频吗?做动作迁移就要。只想让画面里某个元素轻轻动一下,用文字描述更省事,那是另一条路。
参考视频里是别人,能套到我照片上吗?能,这正是这类玩法的用途。模型读的是动作轨迹,不是长相。
为什么脚总是打滑?参考视频里脚离地了,而源图里没有地面。换成脚踩实、地面可见的素材,或者把动作压到原地。
动作能更长吗?5 秒和 10 秒是两档。要更长就把两段拼起来,别指望一条长镜头从头稳到尾。
横屏素材能转竖屏吗?能,但动作幅度要往回收,而且尽量在竖屏里直接生成——横转竖裁掉的两侧,往往正是手臂挥出去的地方。
生成完发现方向反了怎么办?检查参考视频里主体朝哪边。朝向对不上时,先把参考视频水平翻转再试,比改提示词快。
下一步
想把动作固定成一支舞,看照片跳舞;想把视频里的人换掉、动作保留,看用模板替换视频人物。照片本身哪些部分能动、哪些动不了,看怎么把照片变成视频。
找一段干净的单人全身素材,打开模板页,先跑一条 5 秒的原地动作。
不想自己先攒素材,也可以直接打开动作控制工具,传一段参考视频和一张照片,把上面这几步在页面里走一遍;哪一步的输入不合格,出来的结果会和本文明说的一样。